

في 9 نوفمبر 2026 أطلقت شركة أنثروبيك (Anthropic) نموذجها الجديد Claude Fable 5.2، ومعه نموذج شقيق اسمه Claude Mythos 5.2. وتصفهما الشركة بأنهما أقوى ما لديها للأعمال التقنية الأصعب. اللافت أن النموذج جاء أذكى من سابقه وأرخص منه بنسبة 20% في الوقت نفسه، وهذا نادر في سوق اعتادت أن يعني فيه الأقوى الأغلى.
في هذا الدليل نشرح كل ما تحتاج معرفته عن Fable 5.2: ما الجديد فيه، وكم يكلّف بالدولار والريال، وكيف يقف أمام GPT-6 Astra وGPT-6.1 Sol من OpenAI وGemini 4 Carbon من Google. ونعرض نقاط قوته وضعفه بالأرقام، ومتى يستحق سعره ومتى يكون نموذج أرخص هو الخيار الأذكى.
💡 الإجابة المختصرة: Claude Fable 5.2 هو أقوى نموذج متاح للعموم من أنثروبيك، صدر في 9 نوفمبر 2026. سعره 8 دولارات لكل مليون توكن إدخال و40 دولارًا لكل مليون توكن إخراج، أي أقل بـ20% من Fable 5.1. نافذة سياقه مليون توكن وحد إخراجه 128 ألف توكن. حصل على 65 نقطة في مؤشر الذكاء المستقل من Artificial Analysis، وهي أعلى درجة بين النماذج المقيَّمة وقت الإطلاق. يتفوق في البرمجة الوكيلية والمهام الطويلة واستخدام الحاسوب، لكنه أغلى من منافسين مثل GPT-6.1 Sol وGemini 4 Carbon. لذلك توصي أنثروبيك نفسها بـOpus 5.5 للعمل اليومي.
بطاقة تعريف سريعة: Claude Fable 5.2 في سطور
البند | التفاصيل |
|---|---|
الشركة المطوّرة | Anthropic |
تاريخ الإطلاق | 9 نوفمبر 2026 |
معرّف النموذج في الـ API |
|
سعر الإدخال | 8 دولارات لكل مليون توكن (30 ريالًا تقريبًا) |
سعر الإخراج | 40 دولارًا لكل مليون توكن (150 ريالًا تقريبًا) |
نافذة السياق | مليون توكن (1M) |
أقصى إخراج | 128 ألف توكن |
التفكير | مفعّل دائمًا (تفكير تكيّفي) ويُضبط عمقه بخمسة مستويات جهد |
السرعة | أسرع حتى 30% من Fable 5.1، و"الوضع السريع" يرفع السرعة حتى 2.5 ضعف |
المنصات | تطبيقات Claude المدفوعة، Claude Code، منصة Claude للمطورين، AWS، Google Cloud، Microsoft Azure |
النموذج الشقيق | Claude Mythos 5.2 (النموذج نفسه بقيود أقل، للمؤسسات الموثّقة فقط) |
ما هو Claude Fable 5.2؟
Claude Fable 5.2 هو أحدث إصدار من فئة Fable، وهي أعلى فئة نماذج تتيحها أنثروبيك للجمهور. يأتي فوق عائلة Opus المخصّصة للعمل اليومي الاحترافي، وفوق Sonnet وHaiku المخصّصين للسرعة والتكلفة المنخفضة. صُمّم Fable للمهام التي تستغرق ساعات لا ثوانٍ: ترحيل نظام برمجي كامل، أو تدقيق أمني طويل، أو بحث علمي متعدد المراحل، أو تنسيق فريق من الوكلاء الأذكياء يعمل كل منهم على جزء من المشكلة.
بعبارة أبسط: إذا كان Opus هو "المهندس الأول" في فريقك، فإن Fable هو "كبير المهندسين" الذي تستدعيه للمشكلات التي عجز عنها الجميع. هذا ما عبّر عنه أحد مهندسي Shopify حين وصف النموذج بأنه يعمل كمهندس بمستوى Staff.
Fable 5.2 وMythos 5.2: نموذج واحد بوجهين
أكثر ما يربك القراء هو العلاقة بين الاسمين. الحقيقة أنهما النموذج الأساسي نفسه، والفرق في طبقات الحماية فقط:
Fable 5.2: متاح للجميع، ومزوّد بضوابط أقوى في مجالَي الأمن السيبراني والأحياء. تقول أنثروبيك صراحةً إن هذه الضوابط ستحجب معظم المهام المتعلقة بالأمن السيبراني.
Mythos 5.2: بدون تلك القيود، ومتاح فقط للمؤسسات الموثّقة عبر برنامجَي Cyber Verification وLife Sciences Verification، ولعملاء Claude Enterprise ضمن خدمة Claude Security. وتصفه الشركة بأنه أقوى نموذج لديها في هندسة الأمن السيبراني.
بعبارة أخرى: إن كنت شركة برمجيات أو تحليل بيانات أو استشارات فستستخدم Fable 5.2. وإن كنت فريق أمن سيبراني يبحث عن الثغرات فستحتاج إلى التقدّم لبرنامج التحقق للحصول على Mythos.
ما الجديد في Claude Fable 5.2؟ أبرز 9 تحسينات
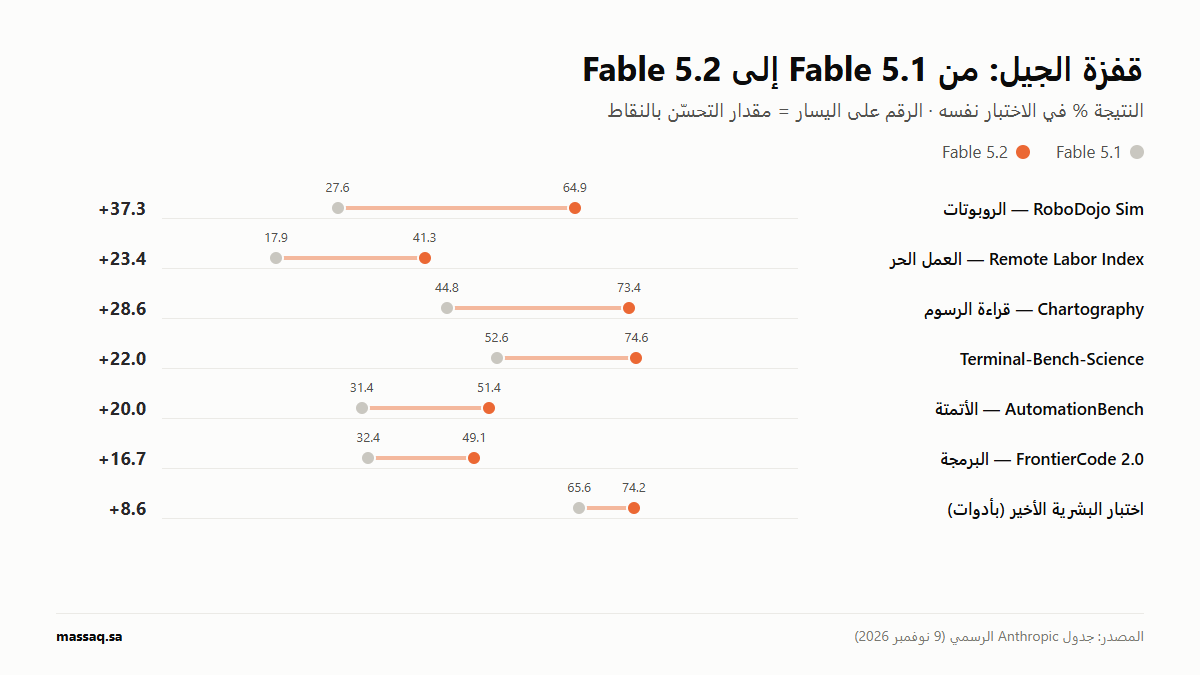
قفزة الجيل: مقدار تحسّن Fable 5.2 مقارنةً بـ Fable 5.1 في الاختبارات نفسها (المصدر: Anthropic).
سعر أقل بـ20%: انخفض من 10/50 دولارًا إلى 8/40 دولارًا لكل مليون توكن إدخال/إخراج، رغم أن النموذج أقوى.
سرعة أعلى حتى 30% في توليد المخرجات مقارنةً بـ Fable 5.1.
الوضع السريع (Fast Mode): يرفع سرعة التوليد حتى 2.5 ضعف بسعر 16/80 دولارًا. وهو متاح في Claude Code ومنصة Claude وClaude على Google Cloud وMicrosoft Foundry.
استهلاك توكنات أقل: عند مستوى الجهد المتوسط، وهو الافتراضي في تطبيقات Claude وClaude Code، يستهلك توكنات أقل من Fable 5.1 لإنجاز العمل نفسه.
قفزة في الروبوتات: ارتفعت نتيجته في RoboDojo Sim من 27.6% إلى 64.9%، أي أكثر من الضعف. وتحكّم فعليًا بروبوتات في مهام مثل حل مكعب الألغاز وفتح غطاء زجاجة والرسم.
تضاعف قدرته على "العمل الحر": في مؤشر Remote Labor Index قفز من 17.9% إلى 41.3%. ويعني ذلك أن 99 مشروعًا من أصل 240 مشروعًا حرًا حقيقيًا جاءت نتيجته فيها بجودة مساوية أو أفضل من نتيجة محترف بشري.
رؤية أدق للرسوم البيانية: ارتفع أداؤه في اختبار Chartography لقراءة الرسوم من 44.8% إلى 73.4%.
دور "المستشار" و"المنسّق": يستطيع Fable 5.2 أن يعمل مستشارًا تستشيره نماذج أصغر مثل Haiku وSonnet وOpus عند المنعطفات الصعبة. ويستطيع أن يعمل منسّقًا يوزّع المهام البسيطة على نماذج أرخص، وهذا يخفض التكلفة الإجمالية للمشاريع الكبيرة.
تواصل أوضح وحجب أقل: يقول المختبرون إنه يشرح عمله بوضوح أكبر، ويعترف بعدم اليقين بدل اختلاق أرقام لم يقِسها. كما انخفضت حالات الحجب الخاطئ بنحو 55% مقارنةً بـ Fable 5.1.
أسعار Claude Fable 5.2 بالتفصيل (بالدولار والريال)
هذا هو القسم الذي يهمّ صاحب القرار. يُحسب سعر نماذج اللغة بـالتوكن، وهو جزء من الكلمة. يساوي مليون توكن تقريبًا 750 ألف كلمة إنجليزية، وأقل من ذلك في العربية. وبما أن الريال السعودي مربوط بالدولار عند 3.75، أضفنا عمودًا بالريال للتسهيل.
نوع الاستخدام | السعر (دولار / مليون توكن) | بالريال تقريبًا |
|---|---|---|
الإدخال (القياسي) | $8 | 30 ر.س |
الإخراج (القياسي) | $40 | 150 ر.س |
إدخال الوضع السريع | $16 | 60 ر.س |
إخراج الوضع السريع | $80 | 300 ر.س |
Batch API (إدخال / إخراج) | $4 / $20 | 15 / 75 ر.س |
قراءة من الذاكرة المؤقتة (Cache Read) | $0.20 | 0.75 ر.س |
كتابة الذاكرة المؤقتة (5 دقائق / ساعة) | $10 / $16 | 37.5 / 60 ر.س |
💰 نصيحة توفير: قراءة الذاكرة المؤقتة (Prompt Caching) أرخص بـ40 مرة من الإدخال العادي (0.20 دولار مقابل 8 دولارات). إذا كان تطبيقك يرسل التعليمات نفسها أو المستندات نفسها في كل طلب، فتفعيل التخزين المؤقت وحده قد يخفض فاتورتك بشكل كبير. والمهام غير العاجلة عبر Batch API تكلّف نصف السعر.
مقارنة الأسعار مع المنافسين
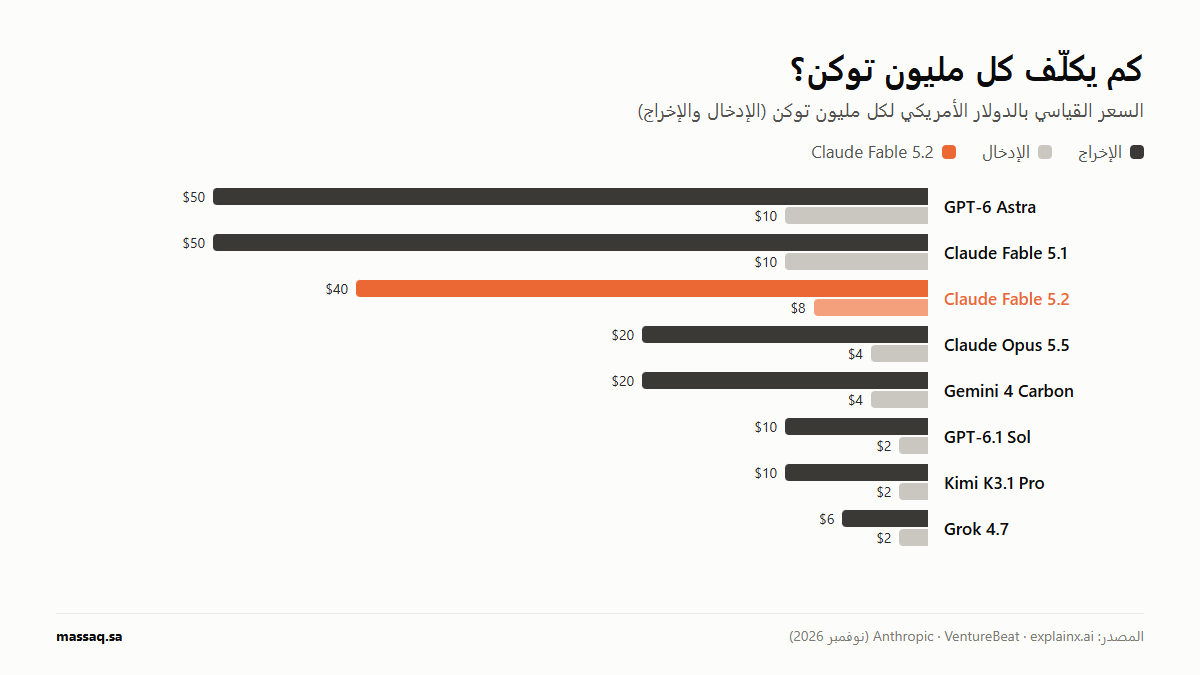
السعر القياسي لكل مليون توكن إدخال وإخراج لأبرز النماذج المتقدمة في نوفمبر 2026.
النموذج | الشركة | إدخال ($/مليون) | إخراج ($/مليون) | ملاحظة |
|---|---|---|---|---|
Claude Fable 5.2 | Anthropic | 8 | 40 | الأعلى أداءً في المؤشر المستقل |
Claude Fable 5.1 | Anthropic | 10 | 50 | الإصدار السابق |
Claude Opus 5.5 | Anthropic | 4 | 20 | توصي به أنثروبيك للعمل اليومي |
GPT-6 Astra | OpenAI | 10 | 50 | أغلى من Fable 5.2 بـ20% |
GPT-6.1 Sol | OpenAI | 2 | 10 | يرتفع إلى 4/15 فوق 272 ألف توكن إدخال |
Gemini 4 Carbon | Google DeepMind | 4 | 20 | سعر تمهيدي 2/10، وإتاحته محدودة |
Grok 4.7 | SpaceXAI | 2 | 6 | الأرخص بين النماذج المغلقة |
Kimi K3.1 Pro | Moonshot | 2 | 10 | أوزان مفتوحة |
DeepSeek V4.1 Flash | DeepSeek | 0.15 | 0.60 | خارج الذروة، ويتضاعف وقت الذروة |
مثال عملي: كم تكلّف مهمة واحدة فعليًا؟
لنأخذ مهمة نموذجية: تحليل مستودع كود أو عقد طويل بحجم 200 ألف توكن إدخال، وإنتاج تقرير بحجم 20 ألف توكن إخراج، بالأسعار القياسية ودون تخزين مؤقت:
النموذج | تكلفة الإدخال | تكلفة الإخراج | الإجمالي | بالريال |
|---|---|---|---|---|
GPT-6 Astra | $2.00 | $1.00 | $3.00 | 11.25 ر.س |
Claude Fable 5.2 | $1.60 | $0.80 | $2.40 | 9.00 ر.س |
Claude Opus 5.5 | $0.80 | $0.40 | $1.20 | 4.50 ر.س |
Gemini 4 Carbon | $0.80 | $0.40 | $1.20 | 4.50 ر.س |
GPT-6.1 Sol | $0.40 | $0.20 | $0.60 | 2.25 ر.س |
لكن انتبه: سعر التوكن ليس هو التكلفة الحقيقية. النموذج الأذكى قد ينجز المهمة من المحاولة الأولى بتوكنات أقل، والأرخص قد يحتاج إلى ثلاث محاولات ومراجعة بشرية. لهذا نحتاج إلى مقياس "التكلفة لكل مهمة منجزة"، وهو موضوع القسم التالي.
مستويات الجهد: السلاح السري (والفخ الخفي) في Fable 5.2
التفكير في Fable 5.2 مفعّل دائمًا ولا يمكن إيقافه. يُتحكَّم في عمقه عبر خمسة مستويات جهد (Effort): منخفض، متوسط، مرتفع، مرتفع جدًا (xhigh)، أقصى (max). الإعداد الافتراضي في الـ API هو "مرتفع"، وفي تطبيقات Claude وClaude Code هو "متوسط".
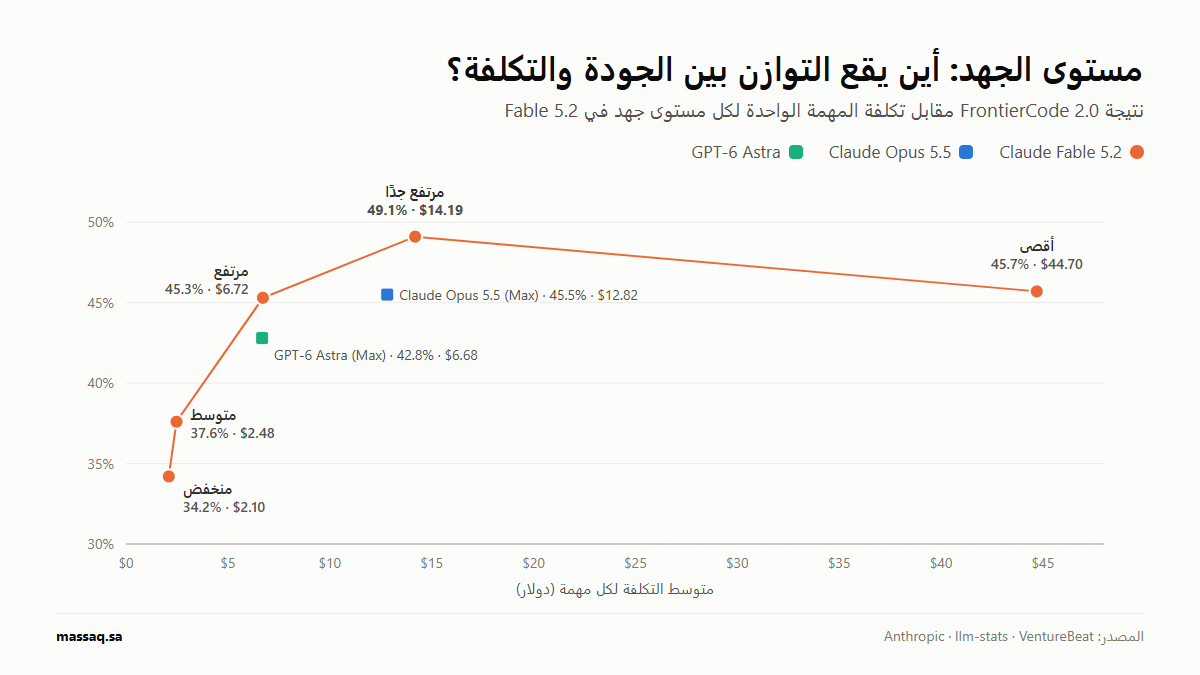
كل نقطة تمثل مستوى جهد: كلما اتجهت يمينًا زادت التكلفة، وكلما ارتفعت زادت الجودة. لاحظ أن "أقصى" أغلى بثلاثة أضعاف من "مرتفع جدًا" وأقل منه نتيجة.
مستوى الجهد | نتيجة FrontierCode 2.0 | متوسط التكلفة لكل مهمة | متى تستخدمه؟ |
|---|---|---|---|
منخفض (Low) | 34.2% | $2.10 | المحادثة، التصنيف، المهام الروتينية |
متوسط (Medium) | 37.6% | $2.48 | العمل اليومي داخل التطبيقات |
مرتفع (High) | 45.3% | $6.72 | نقطة البداية الموصى بها للعمل الجاد |
مرتفع جدًا (Xhigh) | 49.1% | $14.19 | البرمجة الوكيلية المعقدة عندما يُثبت القياس الفائدة |
أقصى (Max) | 45.7% | $44.70 | نادرًا، لقياس سقف النموذج فقط |
أهم ثلاث ملاحظات من هذا الجدول:
عند مستوى "مرتفع" يحقق Fable 5.2 تقريبًا أفضل نتيجة لـ Opus 5.5 (45.5%) بنحو نصف التكلفة لكل مهمة.
مستوى "أقصى" فخ مكلف: يكلّف 44.70 دولارًا للمهمة، أي ثلاثة أضعاف "مرتفع جدًا"، ويعطي نتيجة أقل.
في المستويات العليا قد يستدعي النموذج وكلاء فرعيين لمراجعة عمله، وهذه تكلفة إضافية لا تظهر في سعر التوكن.
Fable 5.2 مقابل المنافسين: المقارنة الشاملة بالأرقام
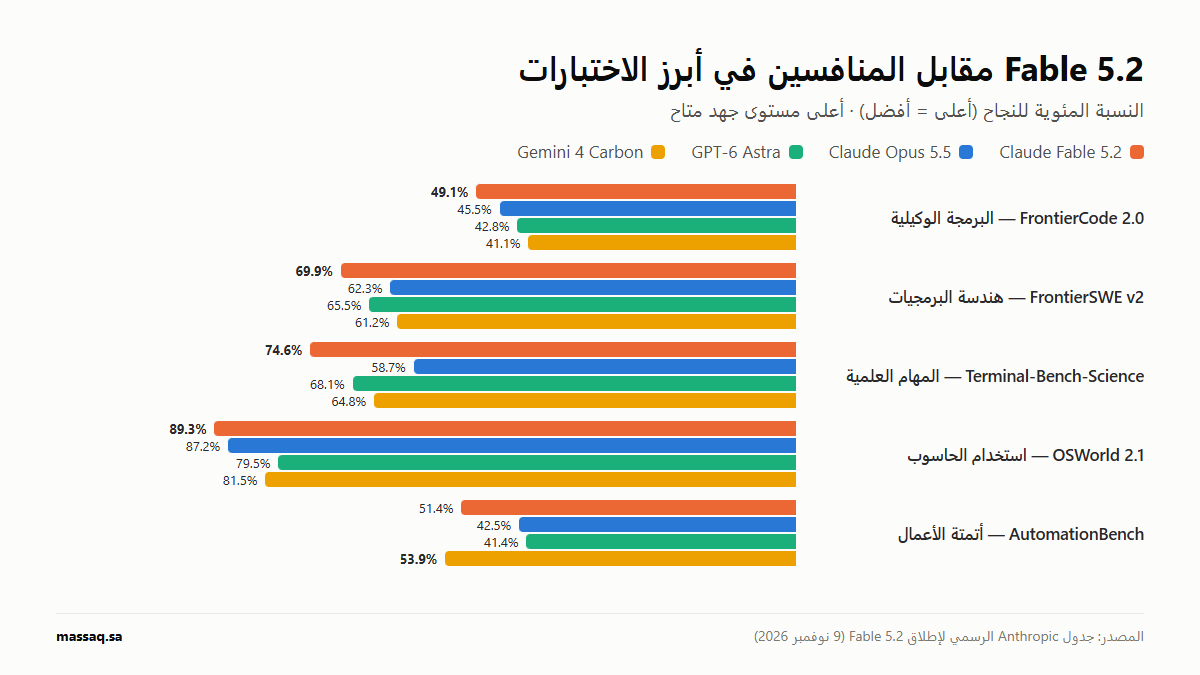
أداء Fable 5.2 مقابل أبرز المنافسين في خمسة اختبارات رئيسية (المصدر: جدول Anthropic الرسمي).
الاختبار المعياري | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
FrontierCode 2.0 (برمجة وكيلية) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
FrontierSWE v2 (هندسة برمجيات) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
AutomationBench (أتمتة الأعمال) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
OSWorld 2.1 (استخدام الحاسوب) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
WANDR (البحث الوكيلي) | 82.1% | 68.7% | 72.3% | — | — |
RoboDojo Sim (الروبوتات) | 64.9% | 27.6% | 39.4% | 29.8% | — |
Remote Labor Index (العمل الحر) | 41.3% | 17.9% | 21.3% | 20.8% | — |
Humanity's Last Exam (بأدوات) | 74.2% | 65.6% | 67.7% | 57.2% | — |
Chartography (قراءة الرسوم) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
AA-Briefcase v1.1 (Elo) | 1785 | 1669 | 1800 | 1569 | 1611 |
"—" تعني أن النتيجة غير منشورة. الأرقام من جدول أنثروبيك الرسمي بأعلى مستوى جهد متاح، وقد تختلف عن أرقام الشركات المنافسة في إعلاناتها الخاصة.
رأي طرف مستقل: مؤشر Artificial Analysis
أغلب الأرقام أعلاه منشورة من أنثروبيك نفسها، لذلك من المهم النظر إلى تقييم مستقل. في مؤشر الذكاء من Artificial Analysis (الإصدار الخامس) حصل Fable 5.2 على 65 نقطة، وهي أعلى درجة بين النماذج المقيَّمة وقت الإطلاق، بفارق 6 نقاط عن أقرب منافس.
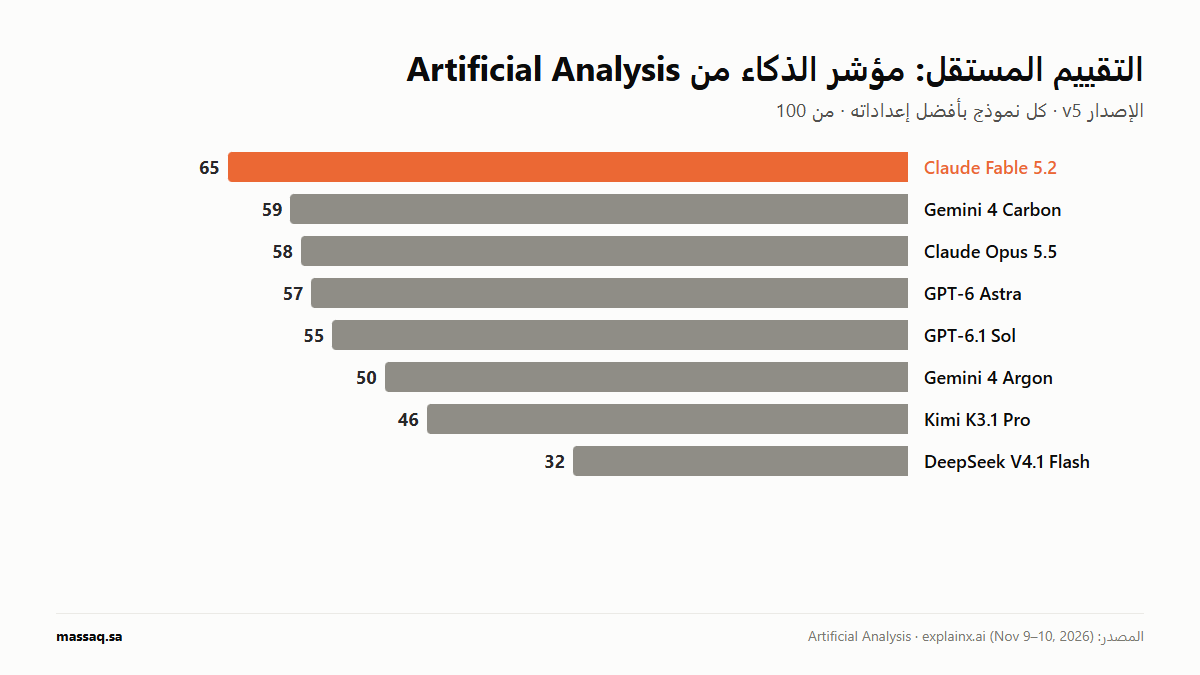
ترتيب أبرز النماذج في مؤشر Artificial Analysis للذكاء، الإصدار الخامس (نوفمبر 2026).
ويكشف المؤشر نفسه عن جانب التكلفة والسرعة:
الإعداد | درجة المؤشر | التكلفة لكل مهمة | الوقت لكل مهمة | سرعة الإخراج |
|---|---|---|---|---|
Fable 5.2 (أقصى) | 65 | $26.54 | 46.4 دقيقة | 98 توكن/ث |
Fable 5.2 (مرتفع) | 62 | $9.08 | 17.6 دقيقة | 92 توكن/ث |
Gemini 4 Carbon (مرتفع) | 60 | $7.76 | 26.5 دقيقة | 77 توكن/ث |
Fable 5.2 (متوسط) | 56 | $3.80 | 8.3 دقيقة | 86 توكن/ث |
GPT-6.1 Sol | 55 | $1.27 | 19.7 دقيقة | 57 توكن/ث |
Fable 5.2 (منخفض) | 54 | $3.10 | 6.5 دقيقة | 92 توكن/ث |
Fable 5.2 مقابل GPT-6 Astra
هذه المواجهة الأوضح. يتفوق Fable 5.2 في البرمجة الوكيلية (49.1% مقابل 42.8%)، وفي هندسة البرمجيات (69.9% مقابل 65.5%)، وفي استخدام الحاسوب (89.3% مقابل 79.5%)، وفي "اختبار البشرية الأخير" (74.2% مقابل 57.2%). وهو أرخص بـ20% في سعر التوكن (8/40 مقابل 10/50). في المقابل يتقدّم Astra في اختبار ARC-AGI-3 (98.6% مقابل 97.72%). وتكلفة أفضل نتيجة له في FrontierCode هي 6.68 دولارات للمهمة، وهي قريبة جدًا من تكلفة Fable عند مستوى "مرتفع" (6.72 دولارات) الذي يعطي نتيجة أعلى.
الحكم: Fable 5.2 هو الخيار الأفضل في أغلب المقاييس وبسعر أقل.
Fable 5.2 مقابل GPT-6.1 Sol
Sol هو "الحصان الاقتصادي" من OpenAI. سعره ربع سعر Fable (2/10 دولارات)، ونافذة سياقه 1.05 مليون توكن، ويتيح خصم 95% على الإدخال المخزّن مؤقتًا. لكنه يحصل على 55 نقطة في مؤشر Artificial Analysis مقابل 65 لـ Fable. تكلفة المهمة الواحدة في المؤشر 1.27 دولار فقط له مقابل 26.54 دولارًا لـ Fable بأقصى جهد. وFable أسرع في التوليد (98 مقابل 57 توكن/ثانية)، لكنه يستغرق وقتًا أطول لإنهاء المهمة عند الجهد الأقصى لأنه يفكّر أكثر.
الحكم: Sol للمهام الروتينية واسعة النطاق، وFable للمهام الصعبة عالية المخاطر التي يبرّر فيها فارق الجودة التكلفة.
Fable 5.2 مقابل Gemini 4 Carbon
Gemini 4 Carbon هو المنافس الأقرب في المؤشر المستقل بـ59 نقطة. وهو يتفوق على Fable في أتمتة سير العمل التجاري (AutomationBench: 53.9% مقابل 51.4%)، وسعره نصف سعر Fable (4/20 دولارات، مع سعر تمهيدي 2/10). لكن Fable يتقدّم عليه في البرمجة واستخدام الحاسوب والمهام العلمية. والعائق الأكبر أمام Carbon حاليًا هو الإتاحة المحدودة، إذ تشير التقارير إلى أنه غير متاح بعد للاستدعاء العام عبر API.
الحكم: Carbon خيار جذاب لأتمتة الأعمال إن توفر لك، وFable أشمل وأكثر إتاحة.
Fable 5.2 مقابل Claude Opus 5.5: المنافسة داخل البيت
هذه المقارنة الأهم عمليًا. سعر Opus 5.5 نصف سعر Fable تمامًا (4/20 دولارات)، وأنثروبيك نفسها تصفه بأنه أقوى نموذج للعمل اليومي وتوصي به لمعظم أعمال البرمجة والمعرفة. ويتفوق Opus على Fable في مقياسَي AA-Briefcase Elo (1800 مقابل 1785) وGDPval-AA (1866 مقابل 1831). أما في البرمجة الطرفية (Terminal-Bench 4.0) فالفارق ضئيل جدًا (67.6% مقابل 66.4%).
لكن Fable يبتعد بوضوح في المهام الطويلة والمعقدة: الروبوتات (64.9% مقابل 39.4%)، والعمل الحر الحقيقي (41.3% مقابل 21.3%)، والرياضيات المتقدمة. في تجربة إثبات مبرهنة فيرما الأخيرة رسميًا بلغة Lean، أنجز فريق من نحو ألف وكيل من نسخة مبكرة من Fable 5.2 المهمة في 30 ساعة، بينما أنجز فريق Opus 5.5 نحو ربعها فقط.
الحكم: ابدأ بـ Opus 5.5، وانتقل إلى Fable 5.2 عندما تصطدم بسقف Opus في المهام الطويلة.
دليل الاختبارات المعيارية: كل نتائج Fable 5.2 حسب نوع الاختبار
الاختبارات المعيارية (Benchmarks) مجموعات مهام موحّدة تُقاس عليها النماذج المختلفة، فتسمح بمقارنتها بإنصاف. ولا يوجد اختبار واحد يكشف كل شيء: نموذج يتفوق في البرمجة قد يتراجع في الطب. لذلك جمعنا هنا كل النتائج المنشورة لـ Fable 5.2 مصنّفة حسب نوع القدرة، مع شرح موجز لما يقيسه كل اختبار، ومقارنتها بـ Claude Opus 5.5 بوصفه أقوى منافس من الشركة نفسها.
1. البرمجة وهندسة البرمجيات
الاختبار | ماذا يقيس؟ | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
FrontierCode 2.0 | البرمجة الوكيلية: ينفّذ النموذج مهام برمجية كاملة بنفسه عبر الأدوات | 49.1% | 45.5% |
FrontierSWE v2 | مهام هندسة برمجيات واقعية داخل مستودعات كود | 69.9% | 62.3% |
Terminal-Bench 4.0 | إنجاز مهام تقنية عبر سطر الأوامر (الطرفية) | 67.6% | 66.4% |
ProgramBench | مهام برمجية طويلة تتطلب إنهاء العمل وتسليمه ضمن حدود السياق | 85.6% | 91.2% |
في ProgramBench نفد سياق Fable قبل التسليم في 68% من المهام. وعندما عُرض عليه حجم السياق المتبقي ارتفعت نتيجته إلى 91.6%.
2. استخدام الحاسوب والبحث الوكيلي
الاختبار | ماذا يقيس؟ | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
OSWorld 2.1 | تشغيل حاسوب حقيقي: فتح التطبيقات والتعامل مع الملفات والواجهات | 89.3% | 87.2% |
WANDR | البحث الوكيلي: العثور على المعلومات عبر جولات بحث متعددة | 82.1% | 72.3% |
3. الاستدلال والمعرفة المتقدمة
الاختبار | ماذا يقيس؟ | Fable 5.2 | المقارنة |
|---|---|---|---|
Humanity's Last Exam (بأدوات) | أسئلة شديدة الصعوبة بمستوى الخبراء في تخصصات كثيرة | 74.2% | Opus 5.5: 67.7% |
ARC-AGI-3 | ألغاز استدلال مجرّد تقيس القدرة على التعلّم من أمثلة قليلة | 97.72% | GPT-6 Astra: 98.6% |
مؤشر Artificial Analysis | مؤشر مستقل يجمع عدة اختبارات في درجة واحدة من 100 | 65 | Opus 5.5: 58 |
4. العلوم والهندسة والروبوتات
الاختبار | ماذا يقيس؟ | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
Terminal-Bench-Science 0.1 | مهام بحث علمي حسابية تُنفَّذ عبر الطرفية | 74.6% | 58.7% |
BenchCAD 2.1 (بأدوات) | التصميم الهندسي بمساعدة الحاسوب (CAD) | 83.5 | 65.3 |
RoboDojo Sim | التحكم في روبوتات داخل بيئة محاكاة | 64.9% | 39.4% |
5. العمل المعرفي والمهني
الاختبار | ماذا يقيس؟ | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
Remote Labor Index | مشاريع عمل حر حقيقية تُقارن نتيجتها بعمل محترفين بشريين | 41.3% | 21.3% |
AutomationBench | أتمتة سير العمل في الأعمال التجارية | 51.4% | 42.5% |
AA-Briefcase v1.1 (معايير التقييم) | مهام عمل معرفي تُقيَّم وفق معايير محددة | 66.1% | 61.2% |
AA-Briefcase v1.1 (Elo) | المهام نفسها بمقارنات مباشرة بين النماذج | 1785 | 1800 |
GDPval-AA (Elo) | مهام مهنية ذات قيمة اقتصادية من وظائف حقيقية | 1831 | 1866 |
6. الرؤية والطب
الاختبار | ماذا يقيس؟ | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
Chartography (بدون أدوات) | قراءة الرسوم البيانية وفهمها بصريًا | 73.4% | 64.4% |
HealthBench | جودة الإجابات في المحادثات الطبية والصحية | 58.8% | 64.3% |
7. الأمن السيبراني والأحياء (نتائج Mythos 5.2)
هذه الاختبارات أجرتها أنثروبيك على Mythos 5.2، وهو النموذج نفسه بلا ضوابط الأمن والأحياء. أما Fable 5.2 المتاح للعموم فيحجب أغلب هذه المهام. وقورنت النتائج بـ Opus 5.5 بعد إزالة ضوابطه.
الاختبار | ماذا يقيس؟ | Mythos 5.2 | Opus 5.5 |
|---|---|---|---|
CVE Rediscovery | إعادة اكتشاف ثغرات أمنية معروفة في برمجيات حقيقية | 89.6% | 81.3% |
CyScenarioBench | سيناريوهات أمن سيبراني متعددة المراحل | 76.3% | 67.6% |
De novo binder design (24 ساعة) | تصميم بروتينات جديدة ترتبط بهدف بيولوجي محدد | 85.1% | 82.6% |
8. الأمان والسلوك
الاختبار | ماذا يقيس؟ | Mythos 5.2 | Opus 5.5 |
|---|---|---|---|
التدقيق السلوكي الآلي (نحو 1,900 سيناريو) | السلوك غير الآمن في مواقف عالية المخاطر (الأقل أفضل) | 2.67 | 2.79 |
الهروب من بيئة العزل (أكثر من 1,800 سيناريو) | نسبة استخدام بيانات اعتماد أو ملفات خارج البيئة المسموحة (الأقل أفضل) | 3.1% | 3.3% |
📌 الخلاصة من كل الاختبارات: من أصل 23 نتيجة في هذا الدليل قورن فيها Fable 5.2 (أو Mythos 5.2) بـ Opus 5.5، تفوّق في 19 نتيجة. أكبر قفزاته في الروبوتات والعمل الحر الحقيقي والتصميم الهندسي، وهي مهام طويلة ومتعددة الخطوات. ويتأخر في 4 نتائج: ProgramBench وHealthBench وتقييمَي Elo للعمل المكتبي (AA-Briefcase وGDPval-AA). أما في ARC-AGI-3 فيتقدم عليه GPT-6 Astra بفارق طفيف. معظم هذه الأرقام منشورة من أنثروبيك نفسها، ومؤشر Artificial Analysis هو المقياس المستقل الوحيد بينها.
إنجازات واقعية: ماذا فعل Fable 5.2 خارج المختبر؟
الأرقام المعيارية مهمة، لكن ما يقنع المؤسسات هو النتائج الملموسة. هذه أبرز الأمثلة التي نشرتها أنثروبيك وعملاؤها:
🖥️ نظام تشغيل في ثمانية أيام: بنى أحد المهندسين نموذجًا أوليًا لنظام تشغيل قابل للإقلاع خلال ثمانية أيام باستخدام أكثر من ألف وكيل فرعي.
🦀 ترحيل من Python إلى Rust: نقل فريق من الوكلاء خدمة إنتاجية كاملة إلى Rust، فأصبحت تقلع أسرع بنحو 26 مرة.
📐 مبرهنة فيرما الأخيرة: صيغت رسميًا في Lean خلال 30 ساعة، بينما استغرقت المحاولة السابقة المعروفة 11 يومًا.
🌌 فيزياء نظرية: حلّ مسألتين مفتوحتين عن الثقوب السوداء في إطار "الثنائية الهولوغرافية"، ونُشرت مسودات البحث.
🔌 تصميم عتاد: صمّم بالتعاون مع شركة Diode ثلاثة أجهزة إلكترونية: مركز مساعد صوتي، وسماعة مكالمات USB، وحيوان أليف افتراضي محمول. عملت الأجهزة الثلاثة دون أي تعديل كهربائي.
📊 Oracle: كتب استعلامات SQL أعادت نتائج صحيحة، في حين أعطى نموذجان آخران مجاميع أعلى من الصحيح بـ5 إلى 8 أضعاف.
🔒 Uber: نفّذ تدقيقًا أمنيًا متواصلًا لمدة 10 إلى 12 ساعة وأنهى المهمة كاملة.
⚠️ للأمانة: هذه الأمثلة اختارتها أنثروبيك وعملاؤها، وتجربة فيرما استخدمت "نسخة مبكرة" من النموذج بمحاولة واحدة لكل نموذج. هي مؤشرات قوية على القدرة، لكنها ليست ضمانًا لنتائج مماثلة في كل مشروع.
نقاط القوة في Claude Fable 5.2
✅ الأعلى ذكاءً في التقييم المستقل: 65 نقطة في مؤشر Artificial Analysis، وهي المرتبة الأولى وقت الإطلاق.
✅ رائد البرمجة الوكيلية: 49.1% في FrontierCode 2.0 و69.9% في FrontierSWE v2، وهي أعلى من كل المنافسين المذكورين.
✅ نفَس طويل: يتميز في المهام التي تستغرق ساعات، مثل الترحيلات البرمجية والتدقيقات الطويلة دون إشراف.
✅ استخدام الحاسوب: 89.3% في OSWorld 2.1، وهي الأعلى بين النماذج المقارنة.
✅ أرخص من سابقه ومن GPT-6 Astra بنسبة 20%، مع سرعة أعلى حتى 30%.
✅ كفاءة عند الجهد المرتفع: يطابق أفضل نتيجة لـ Opus 5.5 في البرمجة بنصف التكلفة لكل مهمة.
✅ نافذة سياق مليون توكن وإخراج حتى 128 ألف توكن.
✅ أمانة أكبر: يعترف بعدم اليقين بدل اختلاق الأرقام، وفق شهادة Cognition.
✅ إتاحة واسعة: متوفر على AWS وGoogle Cloud وAzure، وهذا يسهّل تبنّيه داخل البنية السحابية الحالية للمؤسسات.
✅ أمان محسّن: في اختبار الهروب من بيئة العزل استخدم Mythos 5.2 بيانات اعتماد خارجية في 3.1% فقط من السيناريوهات، مقابل 21% لـ Mythos 5.1.
نقاط الضعف والقيود في Claude Fable 5.2
❌ سعر التوكن مرتفع: ضعف سعر Opus 5.5، وأربعة أضعاف GPT-6.1 Sol.
❌ أغلب الأرقام من أنثروبيك نفسها: بعض النتائج جاءت من تشغيل واحد بلا فترات ثقة، والتقييمات المستقلة ما زالت محدودة.
❌ تراجع في بعض الاختبارات: في HealthBench الطبي سجّل 58.8%، وهي أقل من Fable 5.1 (63.9%) ومن Opus 5.5 (64.3%).
❌ استنزاف السياق: في ProgramBench نفدت نافذة المليون توكن قبل التسليم في 68% من المهام، فهبطت نتيجته إلى 85.6% مقابل 91.2% لـ Opus 5.5. وعندما عُرض عليه حجم السياق المتبقي ارتفعت النتيجة إلى 91.6%.
❌ ليس الأفضل في كل شيء: يتقدّم عليه Gemini 4 Carbon في أتمتة الأعمال، ويتقدّم عليه Opus 5.5 في تقييمات العمل المعرفي المكتبي.
❌ بطء في المهام الثقيلة: عند الجهد الأقصى يستغرق نحو 46 دقيقة للمهمة الواحدة في المؤشر المستقل.
❌ قيود على الأمن السيبراني والأحياء: ضوابطه تحجب معظم مهام الأمن السيبراني، ويحتاج الباحثون إلى Mythos المقيّد بالتحقق.
❌ الاحتفاظ بالبيانات: يتطلب احتفاظًا بالبيانات لمدة 30 يومًا لأغراض المراقبة الأمنية، ولا يدعم "عدم الاحتفاظ بالبيانات" (ZDR) إلا بموافقة خاصة. هذه نقطة مهمة للجهات الحكومية والمالية.
❌ تغييرات تقنية للمطورين: لا يمكن إيقاف التفكير، ولا يدعم فرض استدعاء أداة معيّنة (forced tool_choice). ولا يقرأ كتل تفكيره سوى Fable 5.2 وMythos 5.2، وهذا يتطلب تعديل بعض أنظمة الوكلاء القائمة.
❌ إنهاء مبكر أحيانًا: قد ينهي المهام الطويلة مبكرًا عند مستويات الجهد المنخفض والمتوسط.
أي نموذج تختار؟ دليل القرار السريع
حالة الاستخدام | النموذج المقترح | السبب |
|---|---|---|
ترحيل نظام كامل أو مشروع برمجي يمتد لأيام | Claude Fable 5.2 (جهد مرتفع/مرتفع جدًا) | الأقوى في المهام الطويلة والبرمجة الوكيلية |
البرمجة اليومية والعمل المعرفي المكتبي | Claude Opus 5.5 | نصف السعر، وتوصي به أنثروبيك للعمل اليومي |
روبوت محادثة لخدمة العملاء بحجم كبير | GPT-6.1 Sol أو Claude Haiku 5.5 | تكلفة منخفضة جدًا لكل طلب |
أتمتة سير العمل التجاري | Gemini 4 Carbon (إن توفر) أو Fable 5.2 | Carbon يتصدّر AutomationBench |
أبحاث علمية وتحليل بيانات معقد | Claude Fable 5.2 | 74.6% في Terminal-Bench-Science و74.2% في HLE |
اختبار اختراق واكتشاف ثغرات | Claude Mythos 5.2 (بالتحقق) | Fable يحجب أغلب المهام السيبرانية |
منتج يحتاج أوزانًا مفتوحة واستضافة ذاتية | Kimi K3.1 Pro أو DeepSeek V4.1 | أوزان مفتوحة وتكلفة منخفضة |
كيف تبدأ مع Claude Fable 5.2؟
للأفراد: عبر اشتراكات Claude المدفوعة. مع الإطلاق يحصل المشتركون المؤهلون على عدد من إعادات تعيين حصة Fable، ويُتاح Fable ضمن حتى 50% من حدود الاستخدام الأسبوعية لخطط Pro ومقاعد Team القياسية.
للمطورين: عبر منصة Claude بمعرّف النموذج
claude-fable-5-2، أو عبر Claude Code.للمؤسسات: عبر Amazon Bedrock أو Google Cloud أو Microsoft Azure ضمن العقود السحابية القائمة.
وهذا مثال مبسّط لاستدعاء النموذج عبر Python:
import anthropic

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=16000,
    output_config={"effort": "high"},  # ابدأ بـ high ثم قِس
    messages=[{"role": "user", "content": "حلّل هذا المستودع واقترح خطة ترحيل"}],
)
print(response.content)
🛠️ نصيحة المطورين: ابدأ بمستوى الجهد "مرتفع"، ولا تنتقل إلى "مرتفع جدًا" إلا بعد أن تقيس تحسّنًا فعليًا على مهامك. وتجنّب "أقصى" إلا عند قياس حدود النموذج. واكتب تعليمات أقل تفصيلًا مما اعتدت عليه، فالنماذج الأحدث تعمل أفضل حين تفهم الهدف وتُترك لها حرية التنفيذ.
ماذا يعني Fable 5.2 للشركات في السعودية والخليج؟
مع تسارع برامج التحول الرقمي ضمن رؤية 2030، تتحرك المؤسسات السعودية من مرحلة "تجربة الذكاء الاصطناعي" إلى "تشغيله في الإنتاج". ويقدّم Fable 5.2 فرصًا عملية واضحة:
تحديث الأنظمة القديمة: ترحيل الأنظمة الحكومية والمصرفية القديمة إلى تقنيات حديثة بسرعة غير مسبوقة. تعرّف على خدمات تطوير البرمجيات المخصصة لدينا.
وكلاء أذكياء للعمليات: أتمتة سير العمل الداخلي من المشتريات إلى الامتثال. اطّلع على حلول الذكاء الاصطناعي في مساق.
تحليل البيانات وذكاء الأعمال: استعلامات SQL دقيقة وتحليل مستندات طويلة بالعربية والإنجليزية. راجع خدمات إدارة البيانات وذكاء الأعمال.
الظهور في محركات الذكاء الاصطناعي: مع تحوّل الباحثين إلى Claude وChatGPT وGemini للحصول على الإجابات، أصبح ظهور علامتك التجارية في هذه الإجابات أولوية. تعرّف على خدمات SEO وGEO وAEO.
لكن انتبه إلى نقطتين قبل التبنّي: متطلب الاحتفاظ بالبيانات 30 يومًا وما يعنيه لسياسات حماية البيانات في جهتك، والتكلفة عند التوسع. لذلك ننصح ببنية هجينة: Fable للمهام الحرجة، وOpus أو Sonnet أو Haiku للباقي. ولمزيد من السياق اقرأ مقالنا عن أثر الذكاء الاصطناعي على ممارسات تطوير البرمجيات، ومقال بناء تطبيقات ويب عالية الأداء قابلة للتوسع.
الأسئلة الشائعة حول Claude Fable 5.2
ما هو Claude Fable 5.2؟
هو أقوى نموذج ذكاء اصطناعي متاح للعموم من شركة أنثروبيك، صدر في 9 نوفمبر 2026. صُمّم للمهام التقنية الأصعب مثل البرمجة الوكيلية والبحث العلمي والمهام الطويلة متعددة الخطوات. نافذة سياقه مليون توكن، ويُخرج حتى 128 ألف توكن.
كم سعر Claude Fable 5.2؟
8 دولارات لكل مليون توكن إدخال و40 دولارًا لكل مليون توكن إخراج، أي نحو 30 و150 ريالًا. الوضع السريع بضعف السعر (16/80 دولارًا)، وBatch API بنصفه (4/20 دولارات)، وقراءة الذاكرة المؤقتة بـ0.20 دولار فقط لكل مليون توكن.
ما الفرق بين Fable 5.2 وMythos 5.2؟
هما النموذج الأساسي نفسه. يحمل Fable 5.2 ضوابط أقوى في الأمن السيبراني والأحياء ومتاح للجميع، أما Mythos 5.2 فبلا هذه القيود ومتاح فقط للمؤسسات الموثّقة عبر برامج التحقق من أنثروبيك.
هل Claude Fable 5.2 أفضل من GPT-6؟
وفق جدول أنثروبيك يتفوق Fable 5.2 على GPT-6 Astra في البرمجة الوكيلية واستخدام الحاسوب و"اختبار البشرية الأخير"، وهو أرخص منه بـ20%. ويتقدّم عليه في المؤشر المستقل لـ Artificial Analysis (65 مقابل 57). أما GPT-6.1 Sol فأرخص بكثير (2/10 دولارات) لكنه أقل أداءً (55 نقطة).
هل أستخدم Fable 5.2 أم Opus 5.5؟
توصي أنثروبيك بـ Opus 5.5 لمعظم الأعمال اليومية لأنه بنصف السعر وقوي جدًا. استخدم Fable 5.2 للمهام الطويلة والمعقدة التي يعجز عنها Opus، مثل ترحيل الأنظمة الكاملة أو المشاريع التي تمتد لساعات من العمل المستقل.
ما مستوى الجهد الأنسب في Fable 5.2؟
ابدأ بمستوى "مرتفع" (high)، فهو يطابق تقريبًا أفضل نتيجة لـ Opus 5.5 بنصف التكلفة لكل مهمة. استخدم "مرتفع جدًا" (xhigh) للبرمجة المعقدة عندما يثبت القياس فائدته. وتجنّب "أقصى" (max) لأنه أغلى بثلاثة أضعاف وقد يعطي نتيجة أقل.
أين يمكنني استخدام Claude Fable 5.2؟
عبر تطبيقات Claude المدفوعة، وClaude Code، ومنصة Claude للمطورين، وعبر Amazon Web Services وGoogle Cloud وMicrosoft Azure.
هل يدعم Claude Fable 5.2 اللغة العربية؟
نعم، يتعامل Fable 5.2 مع العربية فهمًا وكتابةً كسائر نماذج Claude. ونوصي باختبار جودة المخرجات على مستنداتك ومصطلحات قطاعك قبل الاعتماد عليه في الإنتاج.
الخلاصة: هل يستحق Claude Fable 5.2 سعره؟
Claude Fable 5.2 هو أذكى نموذج متاح تجاريًا اليوم بحسب التقييمات المتاحة. ونجحت أنثروبيك في جعله أقوى وأرخص وأسرع من سابقه في آن واحد. يتصدّر البرمجة الوكيلية واستخدام الحاسوب والمهام العلمية، ويتفوق على GPT-6 Astra في الأداء والسعر معًا.
لكنه ليس النموذج المناسب لكل مهمة. سعر التوكن ضعف Opus 5.5، وأغلب أرقامه ما زالت من مصدر واحد، وفيه نقاط ضعف حقيقية في استهلاك السياق وبعض الاختبارات المتخصصة. القاعدة الذهبية: استخدم Fable حيث يصنع الذكاء الفارق، واستخدم النماذج الأرخص حيث تكفي. والمؤسسات التي تبني بنية ذكية تجمع بين النموذجين هي من ستحقق أعلى عائد.
🚀 هل تريد الاستفادة من Claude Fable 5.2 في مؤسستك؟ فريق مساق يساعدك في اختيار النموذج المناسب لكل مهمة، وبناء وكلاء ذكاء اصطناعي يعملون في الإنتاج، وضبط التكلفة من اليوم الأول. تواصل معنا الآن أو اطّلع على أعمالنا السابقة.
المراجع والمصادر
Anthropic. Introducing Claude Fable 5.2 and Claude Mythos 5.2. 9 نوفمبر 2026.
VentureBeat. Anthropic releases Claude Fable 5.2 and Mythos 5.2, pairing new, record-high benchmarks with 20% API cost reduction. نوفمبر 2026.
Artificial Analysis. Claude Fable 5.2 vs Gemini 4 Carbon: Intelligence, Performance & Price.
LLM Stats. Claude Fable 5.2: Anthropic's Long-Horizon Model Gets Cheaper and Pulls Away.
ExplainX. Frontier AI Models Compared: Fable 5.2 vs GPT-6 vs Gemini 4. 10 نوفمبر 2026.
Kingy AI. Claude Fable 5.2 vs GPT-6.1 Sol: Worth 4x the Price?
آخر تحديث: 10 نوفمبر 2026. الأسعار والأرقام صحيحة وقت النشر، وقد تتغير مع تحديثات الشركات.